学习整理自:diffusion model(二):DDIM技术小结 (denoising diffusion implicit model) | 莫叶何竹🍀 (myhz0606.com),欢迎阅读原文

文章基本信息

  • 文章名称:Denoising Diffusion Implicit Models
  • 发表会议/年份:ICLR 2021
  • 作者:Jiaming Song, Chenlin Meng & Stefano Ermon
  • 单位:Stanford University

背景

尽管去噪扩散概率模型(DDPM)无需对抗训练即可实现高质量图像生成,但其采样过程依赖于马尔可夫假设,需要较多的时间步才能得到较好的生成效果。本文介绍的去噪扩散隐式模型(DDIM)是一种更有效的迭代隐式概率模型,训练过程与DDPM相同,但采样过程比DDPM快10到50倍。

DDPM为何慢

从DDPM中我们知道,其扩散过程(前向过程,或加噪过程,forward process)被定义为一个马尔可夫过程:

q(x1:T∣x0):=∏t=1Tq(xt∣xt−1),q(x_{1:T}|x_0) := \prod_{t=1}^{T} q(x_t|x_{t-1}),

其中:

q(xt∣xt−1)=N(xt;αtxt−1,(1−αt)I)q(x_t|x_{t-1}) = \mathcal{N}(x_t; \sqrt{\alpha_t}x_{t-1}, (1-\alpha_t)\mathbf{I})

通过这样设置,前向过程有一个很好的性质,可以通过 x0x_0 得到任意时刻 xtx_t 的分布,而无需繁琐的链式计算:

q(xt∣x0):=∫q(x1:t∣x0)dx1:(t−1)=N(xt;αtˉx0,(1−αtˉ)I)(1)q(x_t|x_0) := \int q(x_{1:t}|x_0) dx_{1:(t-1)} = \mathcal{N}(x_t; \sqrt{\bar{\alpha_t}}x_0, (1-\bar{\alpha_t})\mathbf{I})\tag{1}

其去噪过程(也有叫逆向过程,reverse process)也是一个马尔可夫过程:

pθ(x0:T)=p(xT)∏t=1Tpθ(xt−1∣xt),p_\theta(x_{0:T}) = p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1}|x_t),

其中:

p(xT):=N(0,I),p(x_T) := \mathcal{N}(0, \mathbf{I}),

并且:

pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),σtI)p_\theta(x_{t-1}|x_t) = \mathcal{N}(x_{t-1}; \mu_\theta(x_t, t), \sigma_t\mathbf{I})

从式 (1) 可以看出,当 tt 足够大时, q(xt∣x0)q(x_t|x_0) 对所有 x0x_0 都收敛于标准高斯分布。因此DDPM在去噪过程中定义:

pθ(xT):=N(0,I)p_\theta(x_T) := \mathcal{N}(0, \mathbf{I})

并且采用一个较大的采样时间步数 TT。在对 pθ(xt−1∣xt)p_\theta(x_{t-1}|x_t) 的推导中,DDPM用到了一阶马尔可夫假设,使得 p(xt∣xt−1,x0)=p(xt∣xt−1)p(x_t|x_{t-1}, x_0) = p(x_t|x_{t-1}),因此重建的步长非常长,导致速度慢。

DDIM推理

DDPM速度慢的本质原因是对马尔可夫假设的依赖,导致重建需要较多的步长。那么不用一阶马尔可夫假设,有没有另一种方法推导出采样分布p(xt−1∣xt,x0)p(x_{t-1}|x_t,x_0)呢?

DDIM所提出的初衷就是:

  • 维持DDPM前向推理过程中的马尔可夫假设(可以直接使用DDPM中所训练的噪声预测模型)
  • 改变DDPM反向推理中的马尔可夫假设让采样分布的推导不依赖马尔可夫假设(这样不需要一步一步推回去)

DDIM采样分布求解

回到我们的目标,如何推出式子左边:

p(xt−1∣xt,x0)=p(xt∣xt−1,x0)⋅p(xt−1∣x0)p(xt∣x0)p(x_{t-1} | x_t, x_0) = \frac{p(x_t | x_{t-1}, x_0) \cdot p(x_{t-1} | x_0)}{p(x_t | x_0)}

但是这里右边式子中p(xt∣xt−1,x0)p(x_t|x_{t-1},x_0)我们是不知道的,为了求解式子左边,在DDPM中我们是根据一阶马尔可夫假设假设了p(xt∣xt−1,x0)=p(xt∣xt−1)p(x_t|x_{t-1},x_0)=p(x_t|x_{t-1})。从而推出左边p(xt−1∣xt,x0)p(x_{t-1}|x_t,x_0)为正态分布,然后得出答案。

根据DDPM的结果参考,采样分布p(xt−1∣xt,x0)p(x_{t-1}|x_t,x_0)是一个高斯分布,且均值是x0,xtx_0,x_t的线性函数。

在DDIM中,为了不依赖p(xt∣xt−1,x0)p(x_t|x_{t-1},x_0)(马尔可夫假设),作者做出了更为大胆的假设,作者假设p(xt−1∣xt,x0)p(x_{t-1}|x_t,x_0)为任意正态分布,只需要满足下述等式即可:

p(xt−1∣xt,x0)=N(xt−1;λx0+kxt,σt2I)p(x_{t-1}|x_t,x_0)=\mathcal{N}(x_{t-1};\lambda x_0+kx_t,\sigma^2_tI)

该采样分布有3个自由变量λ,k,σt\lambda,k,\sigma_t,但是DDIM要维持与DDPM一致的正向推理分布:q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(x_t|x_0)=\mathcal{N}(x_t;\sqrt{\bar\alpha_t}x_0,(1-\bar{\alpha}_t)I) 。

根据数学归纳法,只需要保证q(xt−1∣x0)=N(xt−1;αˉt−1x0,(1−αˉt−1)I)q(x_{t-1}|x_0) = \mathcal{N}(x_{t-1};\sqrt{\bar\alpha_{t-1}}x_0,(1-\bar{\alpha}_{t-1})I).

所以最终问题变为了,已知q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(x_t|x_0)=\mathcal{N}(x_t;\sqrt{\bar\alpha_t}x_0,(1-\bar{\alpha}_t)I),请寻找p(xt−1∣xt,x0)=N(xt−1;λx0+kxt,σt2I)p(x_{t-1}|x_t,x_0)=\mathcal{N}(x_{t-1};\lambda x_0+kx_t,\sigma^2_tI)的一组解λ∗,k∗,σt∗\lambda^*,k^*,\sigma_t^*,使得q(xt−1∣x0)=N(xt−1;αˉt−1x0,(1−αˉt−1)I)q(x_{t-1}|x_0) = \mathcal{N}(x_{t-1};\sqrt{\bar\alpha_{t-1}}x_0,(1-\bar{\alpha}_{t-1})I)。

即使得下式成立:

∫xtp(xt−1∣xt,x0)q(xt∣x0)dxt=q(xt−1∣x0)\int_{x_t} p(x_{t-1} | x_t, x_0) q(x_t | x_0) dx_t = q(x_{t-1} | x_0)


可以使用待定系数法进行求解

首先对xt−1x_{t-1}和ϵt−1′\epsilon'_{t-1}进行采样得:xt−1=λx0+kxt+σtϵt−1′ϵt−1′∼N(0,I)x_{t-1} = \lambda x_0+kx_t+\sigma_t\epsilon'_{t-1}\quad\epsilon'_{t-1}\sim\mathcal{N}(0,I)

根据q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(x_t | x_0) = \mathcal{N}(x_t; \sqrt{\bar\alpha_t}x_0, (1 - \bar\alpha_t)I),可采样xt,ϵt′∼N(0,I)x_t,\epsilon_t'\sim\mathcal{N}(0,I):

xt=αˉtx0+1−αˉtϵt′x_t = \sqrt{\bar\alpha_t} x_0 + \sqrt{1 - \bar\alpha_t} \epsilon_t'

我们直接带入:

xt−1=λx0+k(αˉtx0+1−αˉtϵt′)+σtϵt−1′x_{t-1} = \lambda x_0 + k\left(\sqrt{\bar{\alpha}_{t}}x_0 + \sqrt{1-\bar\alpha_t }\epsilon_t'\right) + \sigma_t \epsilon_{t-1}'

合并同类项得到:

xt−1=(λ+kαˉt)x0+(k2(1−αˉt)+σt2)ϵˉt−1ϵˉt−1∼N(0,I)x_{t-1} = (\lambda + k\sqrt{\bar{\alpha}_t})x_0 +\sqrt{(k^2(1-\bar\alpha_t)+\sigma_t^2)} \bar\epsilon_{t-1} \quad \quad \bar\epsilon_{t-1} \sim \mathcal{N}(0, I)

根据q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)q(x_t | x_0) = \mathcal{N}(x_t; \sqrt{\bar\alpha_t}x_0, (1 - \bar\alpha_t)I),可采样xt−1,ϵt−1∼N(0,I)x_{t-1},\epsilon_{t-1}\sim\mathcal{N}(0,I):

xt−1=αˉt−1x0+1−αˉt−1ϵt−1x_{t-1} = \sqrt{\bar\alpha_{t-1}} x_0 + \sqrt{1 - \bar\alpha_{t-1}} \epsilon_{t-1}

结合上面两个式子,不难得到:

{λ+kαˉt=αˉt−1k2(1−αˉt)+σt2=1−αˉt−1\begin{cases} \lambda + k\sqrt{\bar{\alpha}_t} = \sqrt{\bar{\alpha}_{t-1}} \\ k^2(1 - \bar{\alpha}_t) + \sigma_t^2 = 1 - \bar{\alpha}_{t-1} \end{cases}

然后解得:

k∗=1−αˉt−1−σt21−αˉtk^* = \frac{\sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2}}{\sqrt{1 - \bar{\alpha}_t}}

λ∗=αˉt−1−1−αˉt−1−σt2αˉt1−αˉt\lambda^* = \sqrt{\bar{\alpha}_{t-1}} - \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \frac{\sqrt{\bar{\alpha}_t}}{\sqrt{1 - \bar{\alpha}_t}}

σt∗=σ\sigma_t^* = \sigma

综上将上面三个参数k∗,λ∗,σt∗k^*,\lambda^*,\sigma_t^*带入我们可以得到:

p(xt−1∣xt,x0)=N(xt−1;αˉt−1x0+1−αˉt−1−σt2xt−αˉtx01−αˉt,σt2I)p(x_{t-1}|x_t,x_0) = \mathcal{N}\left(x_{t-1};\sqrt{\bar{\alpha}_{t-1}}x_0 + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2}\frac{ x_t- \sqrt{\bar{\alpha}_t}x_0}{\sqrt{1 - \bar{\alpha}_t}}, \sigma_t^2I\right)

综上,说明可以找到一组解满足题述条件。其中,不同的σt\sigma_t对应不同的生成过程。由于前向过程没变,故可以直接用DDPM训练的噪声预测模型。采样过程如下:

xt−1=αˉt−1x0+1−αˉt−1−σt2(xt−αˉtx01−αˉt)+σtϵx_{t-1} = \sqrt{\bar{\alpha}_{t-1}} x_0 + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2} \left( \frac{x_t - \sqrt{\bar{\alpha}_t} x_0}{\sqrt{1 - \bar{\alpha}_t}} \right) + \sigma_t \epsilon

然后同DDPM,我们将x0x_0用xtx_t和ϵθ\epsilon_\theta替代。

x0=1αˉt(xt−1−αˉtϵθ(xt,t))x_0 = \frac{1}{\sqrt{\bar{\alpha}_t}} \left( x_t - \sqrt{1 - \bar{\alpha}_t} \epsilon_\theta(x_t, t) \right)

最终化简得:

xt−1=αˉt−1xt−1−αˉtϵθ(xt,t)αˉt+1−αˉt−1−σt2ϵθ(xt,t)+σtϵx_{t-1} = \sqrt{\bar{\alpha}_{t-1}}\frac{ x_t - \sqrt{1 - \bar\alpha_t} \epsilon_{\theta}(x_t, t)}{\sqrt{\bar\alpha_t}} + \sqrt{1 - \bar{\alpha}_{t-1} - \sigma_t^2 }\epsilon_{\theta}(x_t, t) + \sigma_t \epsilon

其中只有σt\sigma_t是未知的,需要注意以下两个σt\sigma_t的特殊取值:

  1. 当σt=(1−αˉt−1)/(1−αˉt)1−αˉt/αˉt−1\sigma_t=\sqrt{(1-\bar\alpha_{t-1})/(1-\bar\alpha_t)}\sqrt{1-\bar\alpha_t/\bar\alpha_{t-1}},此时的生成过程与DDPM一致
  2. 当σt\sigma_t为0时,此时采样过程中添加的随机噪声项为0,采样过程是确定的,就是作者所提出的DDIM,此时的递推公式为:

xt−1=αˉt−1xt−1−αˉtϵθ(xt,t)αˉt+1−αˉt−1ϵθ(xt,t)x_{t-1} = \sqrt{\bar{\alpha}_{t-1}}\frac{ x_t - \sqrt{1 - \bar\alpha_t} \epsilon_{\theta}(x_t, t)}{\sqrt{\bar\alpha_t}} + \sqrt{1 - \bar{\alpha}_{t-1}} \epsilon_{\theta}(x_t, t)

DDIM如何加速采样

上面我们已经推导了DDIM如何从状态tt推导到状态t−1t-1,但是由于DDIM的反向过程没有受到马尔可夫的限制,因此他其实是可以从状态t直接推到前面任意一个状态的,从状态tt推导到前面的状态t−m(m<t)t-m(m < t)可以表示为如下式子:

xt−m=αˉt−mxt−1−αˉtϵθ(xt,t)αˉt+1−αˉt−mϵθ(xt,t)x_{t-m} = \sqrt{\bar{\alpha}_{t-m}} \frac{x_{t} -\sqrt{1 - \bar\alpha_{t}} \epsilon_{\theta}(x_{t}, t)}{\sqrt{\bar\alpha_{t}}} + \sqrt{1 - \bar{\alpha}_{t-m}} \epsilon_{\theta}(x_{t}, t)

一般加速就是将原先是一步一步预测变成nn步nn步进行预测。

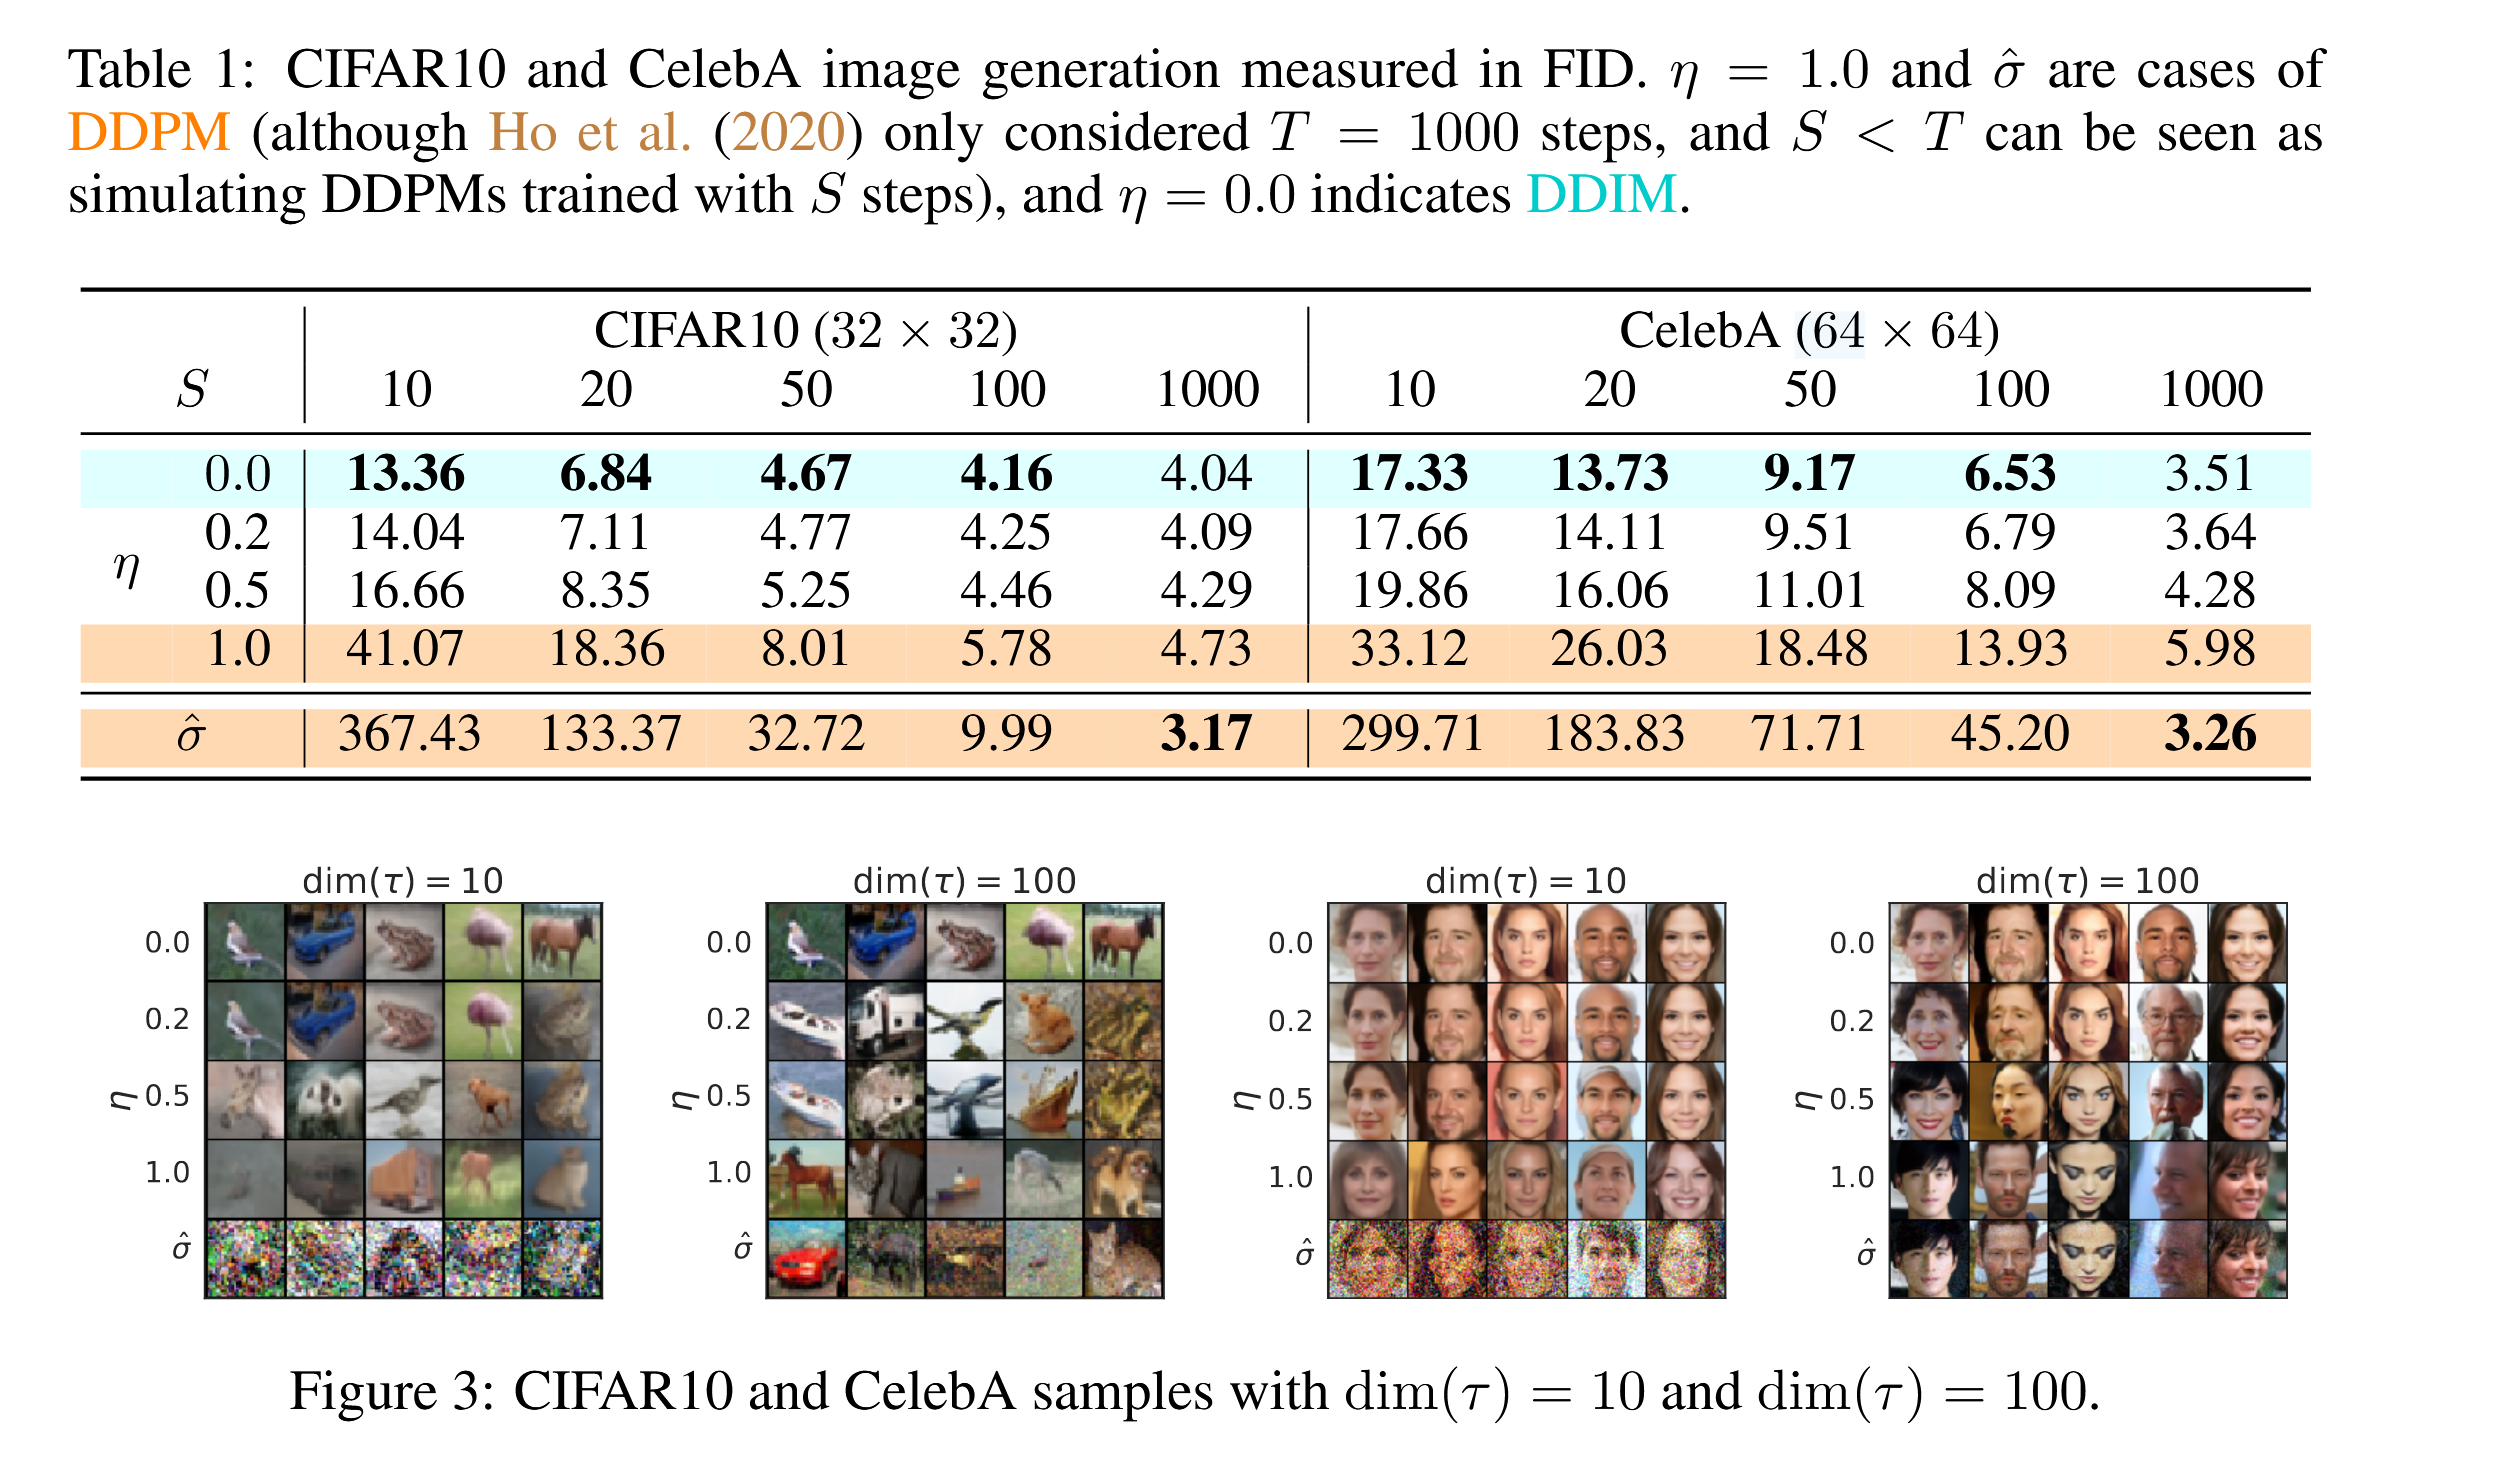
论文中也展示了使用不同的n所带来的结果,可以看到DDIM在较小采样步长时就能达到较好的生成效果。如CIFAR10 S=50就达到了S=1000的90%的效果,与之相对DDPM只能达到10%左右的FID效果。

Pasted image 20240715123626

其中,dim(L)dim(L)表示的是采样序列的长度

DDIM区别于DDPM两个重要的特性

采样一致性

我们知道DDIM将σt\sigma_t​设置为0,这让采样过程是确定的,只受​xTx_T影响。作者发现,当给定xTx_T​,不同的的采样时间序列τ\tau所生成图片都很相近,xTx_T​似乎可以视作生成图片的隐编码信息。

有个小trick,我们在实际的生成中可以先设置较小的采样步长(迭代次数)进行生成,若生成的图片是我们想要的,则用较大的步长重新生成高质量的图片。

语义插值效应(sementic interpolation effect)

即然xTx_T​可能是生成图片的隐空间编码,那么它是否具备其它隐概率模型(如GAN2,VAE)所观察到的语义插值效应呢?

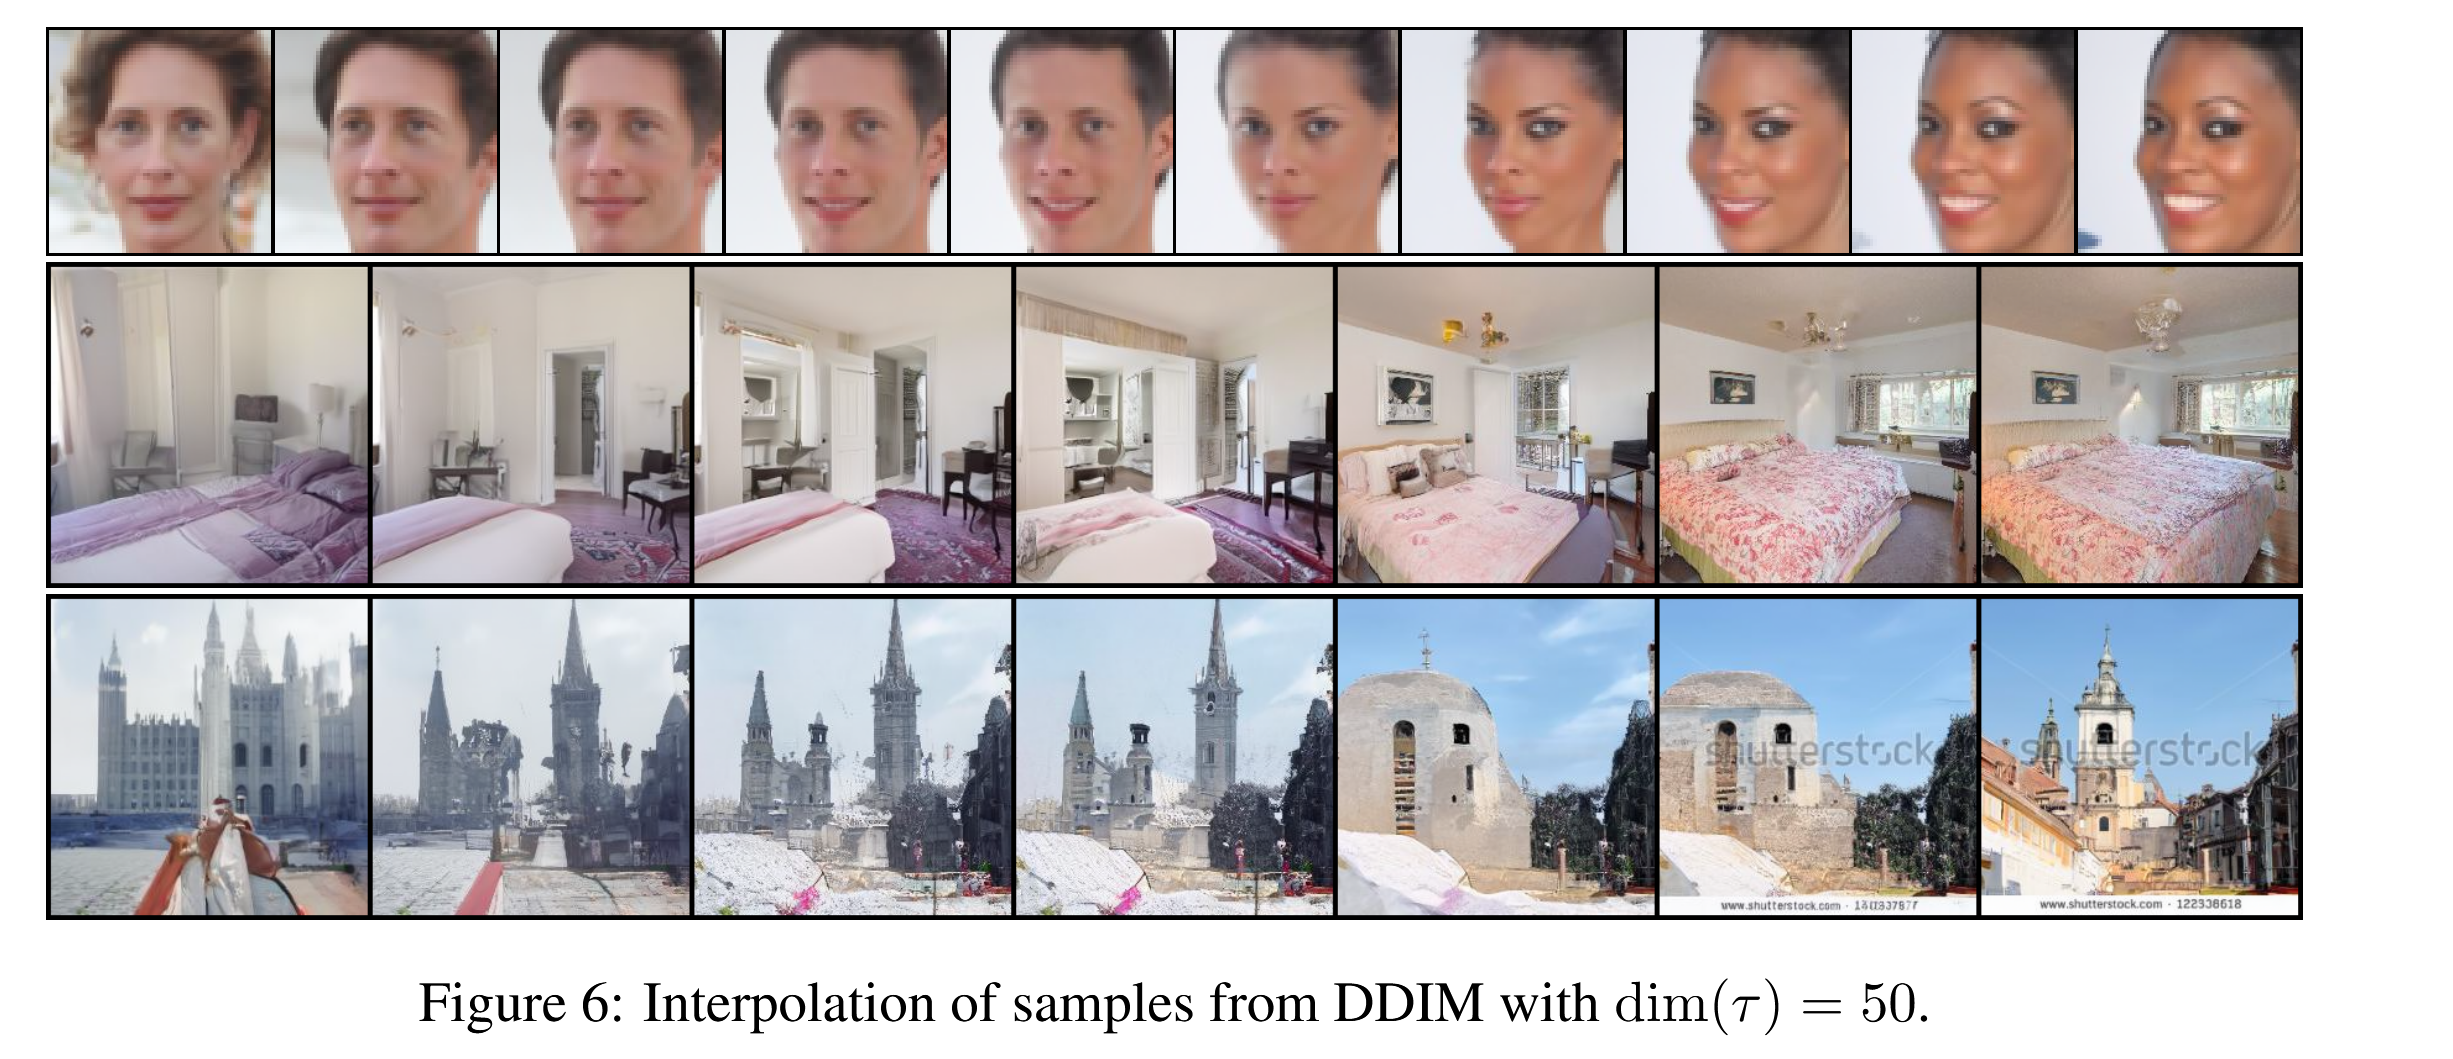
首先从高斯分布采样两个随机变量xT(0),xT(1)x_T^{(0)},x_T^{(1)}​,并用他们做图像生成得到下图最左侧与最右侧的结果。随后用球面线性插值方法(spherical linear interpolation,Slerp)对xT(1),xT(2)x_T^{(1)},x_T^{(2)}他们进行插值,得到一系列中间结果:

xT(α)=sin⁡((1−α)θ)sin⁡(θ)xT(0)+sin⁡(αθ)sin⁡(θ)xT(1)x_{T}^{(\alpha)} = \frac{\sin((1 - \alpha) \theta)}{\sin(\theta)} x_{T}^{(0)} + \frac{\sin(\alpha \theta)}{\sin(\theta)} x_{T}^{(1)}

其中θ=arccos⁡((xT(0))TxT(1)∥xT(0)∥∥xT(1)∥)\theta = \arccos \left( \frac{(x_{T}^{(0)})^T x_{T}^{(1)}}{\| x_{T}^{(0)} \| \| x_{T}^{(1)} \|} \right) ,结果如下所示,可以明确看出来还是有一定语义插值效应的。

Pasted image 20240715125505


本站由 @anonymity 使用 Stellar 主题创建。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。